Newsletter D 05a/2026
Firebird Server Health Check & Backup Monitoring – auch für eigene Hardware
Sie nutzen Firebird auf eigener oder bereits vorhandener Server-Hardware?
Mit unserem 3-Jahres-Servicepaket prüfen und überwachen wir die wichtigsten Grundlagen für einen stabilen Betrieb.
Zum Pauschalpreis von 1.750 € für 3 Jahre führen wir eine initiale Remote-Analyse durch, prüfen Backup- und Restore-Automatisierung, bewerten die Serverleistung per Benchmark und kontrollieren vorhandene Firebird-Konfigurationen.
Zusätzlich erfolgen vierteljährliche Basischecks per Remote-Sitzung. Sie laden uns dazu nach vorheriger E-Mail mit einer Remote-Software Ihrer Wahl ein. Über ein automatisiertes IBEBlock-Script werden regelmäßige Backups zentral protokolliert und überwacht, um Fehler frühzeitig erkennen zu können. ... weiterlesen
Firebird Schreibvorgaenge
Warum die Reihenfolge von Schreibvorgängen für Firebird so wichtig ist
Holger Klemt, September 2026
Die Zuverlässigkeit einer Firebird-Datenbank hängt nicht nur von Firebird selbst ab. Ebenso wichtig ist, dass das darunterliegende Betriebssystem und Storage-System Schreibvorgänge so ausführen und bestätigen, wie es die Datenbank erwartet.
Firebird ist darauf ausgelegt, Änderungen in einer definierten und sorgfältig abgestimmten Reihenfolge auf den Datenträger zu schreiben. Besonders bei aktiviertem Forced Writes stellt Firebird sicher, dass kritische Änderungen tatsächlich auf ein dauerhaftes Speichermedium geschrieben wurden, bevor nachfolgende Operationen als erfolgreich abgeschlossen gelten.
Caches und zusätzliche Storage-Schichten
Moderne Betriebssysteme, RAID-Controller und Storage-Systeme versuchen Schreibzugriffe aus Performancegründen zu optimieren. Schreibvorgänge können beispielsweise gesammelt, zusammengefasst oder in einer anderen Reihenfolge an das physische Speichermedium weitergegeben werden.
Das ist grundsätzlich sinnvoll und bei normalem Dateizugriff meist unproblematisch. Für ein Datenbanksystem ist jedoch entscheidend, dass sogenannte Flush- oder Synchronisationsanforderungen zuverlässig bis zum tatsächlichen Datenträger durchgereicht werden.
Kritisch können deshalb zusätzliche Schichten zwischen Firebird und dem physischen Datenträger sein, zum Beispiel:
- Host- oder Controller-Caches
- RAID- und Storage-Virtualisierung
- Cluster-Dateisysteme
- Block-Level-Replikation
- SAN- oder NAS-Systeme
- Snapshots und andere Virtualisierungsschichten
- nicht batterie- oder flashgesicherte Schreib-Caches
Das Problem entsteht insbesondere dann, wenn eine Schicht einen Schreibvorgang bereits als abgeschlossen meldet, obwohl die Daten noch nicht dauerhaft gespeichert wurden.
Was bei einem Absturz passieren kann
Bei einem Stromausfall, Kernel-Crash oder Hardwarefehler können dadurch bereits bestätigte Schreibvorgänge verloren gehen.
Besonders problematisch ist dies, wenn ein späterer Datenbankzustand bereits auf dem Datenträger angekommen ist, während dazugehörige vorherige Änderungen noch in einem Cache liegen. Dann können innerhalb der Datenbankdatei Informationen entstehen, die nicht mehr zueinander passen.
Genau die von Firebird vorgesehene Schreibstrategie soll solche Situationen verhindern. Voraussetzung dafür ist allerdings, dass Betriebssystem, Treiber, Controller und Storage die entsprechenden Synchronisations-anforderungen korrekt umsetzen.
Forced Writes abzuschalten kann deshalb zwar die Schreibperformance deutlich erhöhen, reduziert aber gleichzeitig eine wichtige Sicherheitsfunktion der Datenbank.
Linux ist nicht automatisch vor solchen Problemen geschützt
Linux-Dateisysteme wie ext4 verfügen über Mechanismen zur kontrollierten Reihenfolge und Absicherung von Schreibvorgängen. Das bedeutet jedoch nicht automatisch, dass jede darunterliegende Storage-Konfiguration dieselben Garantien bietet.
Sobald zusätzliche Cluster-, Mirror-, RAID- oder Virtualisierungsschichten beteiligt sind, muss sichergestellt werden, dass Flushes und Write Barriers auch tatsächlich bis zum persistenten Speichermedium weitergegeben werden.
Für Datenbanksysteme ist daher weniger entscheidend, ob Windows oder Linux eingesetzt wird, sondern ob die gesamte Storage-Kette die vom Datenbanksystem verlangten Garantien zuverlässig einhält.
Ein Beispiel aus der Praxis
In einem von uns betreuten Umfeld kam es vor einigen Jahren bei einem geschäftskritischen Firebird-System zu einem schweren Ausfall. Die Datenbank befand sich auf einer extern aufgebauten Linux-Cluster- und Storage-Lösung.
Nach einem Fehler waren nicht nur die produktive Datenbank, sondern auch die auf Storage-Ebene erzeugte Kopie betroffen. Die Wiederherstellung des Systems erforderte erhebliche Analyse- und Reparaturarbeiten.
Anschließend wurde die Architektur geändert. Seitdem erfolgt die Redundanz nicht mehr durch eine transparente Spiegelung der geöffneten Datenbankdatei, sondern durch eine Replikation auf Firebird-Ebene auf unabhängige Serversysteme. Diese Architektur ist dort seit vielen Jahren zuverlässig im Einsatz.
Redundanz möglichst auf Datenbankebene
Für Firebird-Systeme bevorzugen wir deshalb möglichst einfache und nachvollziehbare Storage-Strukturen.
Redundanz und Hochverfügbarkeit sollten nach Möglichkeit so realisiert werden, dass zwei unabhängig arbeitende Firebird-Server jeweils ihre eigene lokale Datenbankdatei besitzen und die Synchronisation kontrolliert auf Datenbankebene erfolgt.
Das hat mehrere Vorteile:
- Jeder Firebird-Server kontrolliert seine eigene Datenbankdatei.
- Storage-Probleme eines Systems werden nicht automatisch auf eine zweite Datenbankdatei übertragen.
- Die Anzahl zusätzlicher Cache- und Virtualisierungsschichten wird reduziert.
- Fehler lassen sich leichter analysieren und eingrenzen.
- Die für die Datenintegrität wichtigen Schreibmechanismen von Firebird bleiben erhalten.
Sicherheit und Performance sind kein Widerspruch
Die konsequente Einhaltung der notwendigen Schreibreihenfolge erzeugt zwangsläufig eine gewisse Latenz. Gerade bei sehr schreibintensiven Anwendungen kann diese deutlich messbar sein.
Diese zusätzliche Latenz ist jedoch kein unnötiger Performanceverlust, sondern ein wesentlicher Bestandteil der Transaktionssicherheit.
Bei der Optimierung eines Firebird-Servers sollte deshalb nicht versucht werden, diese Sicherheits-mechanismen zu umgehen. Sinnvoller ist es, die Hardware und Storage-Architektur so auszulegen, dass synchrone Schreibvorgänge möglichst schnell ausgeführt werden können.
Eine schnelle Datenbank benötigt schnelles Storage. Eine zuverlässige Datenbank benötigt jedoch vor allem Storage, dessen Zusagen über erfolgreich gespeicherte Daten auch tatsächlich stimmen.
Firebird Write Operations
Why the order of write operations is so important for Firebird
Holger Klemt, September 2026
The reliability of a Firebird database does not depend on Firebird alone. It is equally important that the underlying operating system and storage system execute and acknowledge write operations in the way the database expects.
Firebird is designed to write changes to storage in a defined and carefully coordinated order. In particular, when Forced Writes are enabled, Firebird ensures that critical changes have actually been written to persistent storage before subsequent operations are considered successfully completed.
Caches and additional storage layers
Modern operating systems, RAID controllers and storage systems attempt to optimize write operations for performance reasons. For example, write operations may be collected, combined or passed to the physical storage device in a different order.
This is generally useful and usually unproblematic for normal file access. For a database system, however, it is essential that so-called flush or synchronization requests are reliably passed through all layers down to the actual persistent storage medium.
Additional layers between Firebird and the physical storage device can therefore become critical, for example:
- Host or controller caches
- RAID and storage virtualization
- Cluster file systems
- Block-level replication
- SAN or NAS systems
- Snapshots and other virtualization layers
- Write caches that are not protected by battery backup or flash-based protection
The problem arises in particular when one of these layers reports a write operation as completed even though the data has not yet been permanently stored.
What can happen during a crash
In the event of a power failure, kernel crash or hardware failure, write operations that have already been acknowledged may therefore be lost.
This becomes particularly problematic when a later database state has already reached the storage device while related earlier changes are still waiting in a cache. This can result in information within the database file that is no longer consistent.
Firebird’s carefully designed write strategy is intended to prevent exactly these situations. However, this requires the operating system, drivers, controllers and storage system to correctly implement the corresponding synchronization requirements.
Disabling Forced Writes may therefore significantly improve write performance, but at the same time it removes an important layer of database protection.
Linux Is not automatically protected against these problems
Linux file systems such as ext4 provide mechanisms for controlling the order and durability of write operations. However, this does not automatically mean that every underlying storage configuration provides the same guarantees.
As soon as additional cluster, mirroring, RAID or virtualization layers are involved, it must be ensured that flush operations and write barriers are actually passed through to persistent storage.
For database systems, the more important question is therefore not whether Windows or Linux is being used, but whether the entire storage stack reliably provides the guarantees required by the database system.
A real-world example
Several years ago, a serious failure occurred in a business-critical Firebird environment managed by us. The database was hosted on an externally implemented Linux cluster and storage solution.
Following an error, not only the production database but also the copy created at storage level was affected. Restoring the system required extensive analysis and repair work.
The architecture was subsequently changed. Since then, redundancy has no longer been provided through transparent mirroring of an open database file, but through replication at the Firebird database level to independent server systems. This architecture has been operating reliably in that environment for many years.
Redundancy should ideally be implemented at database level
For Firebird systems, we therefore prefer storage architectures that are as simple and transparent as possible.
Where possible, redundancy and high availability should be implemented in such a way that two independently operating Firebird servers each maintain their own local database file, with synchronization being controlled at the database level.
This approach offers several advantages:
- Each Firebird server controls its own database file.
- Storage problems affecting one system are not automatically transferred to the second database file.
- The number of additional caching and virtualization layers is reduced.
- Problems are easier to analyze and isolate.
- Firebird's write mechanisms, which are essential for data integrity, remain intact.
Security and performance are not mutually exclusive
Strictly maintaining the required order of write operations inevitably introduces a certain amount of latency. In applications with very intensive write activity, this latency can be clearly measurable.
However, this additional latency is not unnecessary performance loss. It is an essential component of transaction safety.
When optimizing a Firebird server, the goal should therefore not be to circumvent these safety mechanisms. A better approach is to design the hardware and storage architecture in such a way that synchronous write operations can be completed as quickly as possible.
A fast database requires fast storage. A reliable database, however, requires storage whose claims regarding successfully stored data actually hold true.
Newsletter 2026/07
You can find a German-language copy of the newsletter online here
Current IBExpert version 2026.07.26
This version includes further adaptations and optimisations to new Firebird 6 features, along with minor bugfixes and improvements.
Download here: https://ibexpert.net/dlc
New: RemoteDBA Service is also available for third-party hardware!
Boost the performance of your existing Firebird server hardware or VM with the IBExpert RemoteDBA Service – find out more here. This service is available worldwide.
Just how powerful is a Firebird server really?
Before the first users start complaining about slow response times:
Test your server with the IBExpert Benchmark – you’ll see the result at a glance.
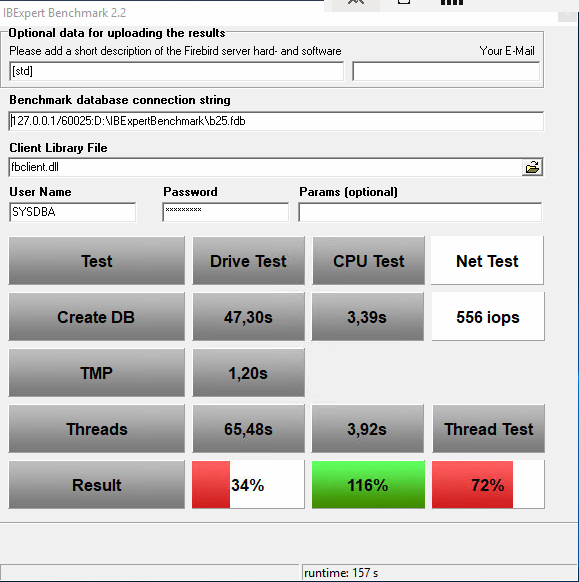 A typical Firebird server in a customer environment |
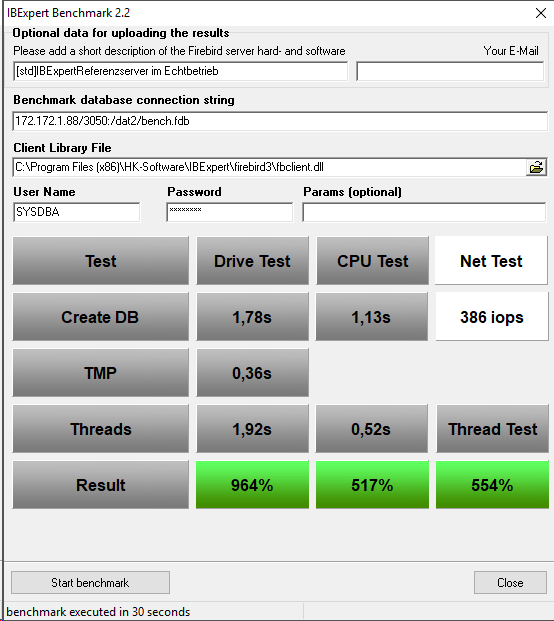 IBExpert Firebird IFS Reference Server |
The IBExpert Benchmark is particularly valuable for software vendors and support teams who need to analyse performance issues reported by customers and objectively determine whether bottlenecks are caused by the server hardware.
Try it for free
Download the free IBExpert Benchmark and test your server in just a few minutes:
https://ibexpert.net/benchmark/setup_benchmark.exe
With a current IBExpert Developer Studio subscription or the IBExpert Day Edition, the Extended and XXL benchmarks are also available.
Up to 30 times better performance for Firebird databases
The IBExpert Benchmark highlights the significant difference: depending on the system being compared, our specially developed Firebird IFS servers achieve up to 30 times higher overall performance than typical standard servers.
Ideal for large databases, large numbers of users and demanding applications – without the need for any changes to your software.
High-performance Firebird IFS servers
Optimise the performance, reliability and security of your Firebird databases with our dedicated Firebird IFS servers. Our solution is complemented by a 4-year hardware maintenance and RemoteDBA service, which includes proactive monitoring, regular backups and competent support.
Find out more about technical specifications, configuration options and support services: https://ibexpert.net/cms/firebird-ifslr-server
Further information about our servers: IFS Firebird Server – consistently designed for database performance
Boost the performance of your existing Firebird server hardware or VM with the IBExpert RemoteDBA service
Would you like to use IBExpert RemoteDBA but already have your own server? It is often not necessary to replace all your hardware. Following an analysis and a practical benchmark, we will, if required, recommend specific additional hardware that you can then purchase yourself.
This allows you to optimise your existing server cost-effectively and significantly speed it up.
This service is available worldwide.
Find out more about IBExpert RemoteDBA here: https://ibexpert.net/cms/ibexpertremotedba
'00-2' is not a valid integer value
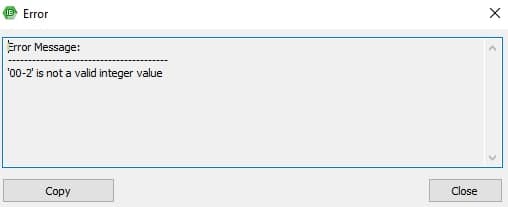
This error appears if you are still using the old deprecated ibexpert.stg to store all your IBExpert settings. It indicates that IBExpert.stg is corrupted, cannot be repaired and user database should be used instead.
To solve this issue configure the IBExpert User Database.
If you have not specified a location yourself: by default, the user database file can always be found in the folder: \HK-Software\IBExpert\ibexpert.udb. This area is user-dependent and even if several users work on one machine, each user has their own file.
If you are still using the old ibexpert.stg (default path: \Documents and Settings\<user>\Application Data\HK-Software\IBExpert\IBExpert.stg) then copy this.
Von UDF zu UDR in Firebird 5
Soundex, Kölner Phonetik, PSQL, Free Pascal und Visual C++ im Praxistest
IBExpert Ltd - Technical White Paper
Executive Summary
Firebird-Anwendungen können die Datenbank-Engine seit vielen Jahren um externe Funktionen erweitern. In älteren Installationen geschah dies häufig mit UDFs (User Defined Functions). Moderne Firebird-Versionen stellen dafür mit UDRs (User Defined Routines) eine deutlich besser integrierte Architektur bereit.
Dieses White Paper beschreibt den Weg von UDF zu UDR anhand eines praktischen Beispiels: phonetische Namensvergleiche mit Soundex, einer deutsch angepassten Soundex-Variante, Kölner Phonetik sowie Distanz- und Ähnlichkeitsfunktionen. Dieselben Funktionen wurden als Firebird-PSQL-Stored-Functions, als native UDR mit Lazarus/Free Pascal und als native UDR mit Microsoft Visual C++ 2022 implementiert.
Der überraschendste Befund: Nicht die Programmiersprache war der wichtigste Performancefaktor. Nachdem Free Pascal und C++ weitgehend denselben Low-Level-Algorithmus verwendeten, lag die optimierte FPC-Version typischerweise nur noch etwa 10 bis 25 Prozent hinter Visual C++.
1. Von UDF zu UDR
UDFs waren über viele Firebird-Generationen ein bewährter Weg, Berechnungen in externe DLLs bzw. Shared Libraries auszulagern. Die alte UDF-Schnittstelle stammt jedoch aus einer früheren Generation des API-Designs.
UDRs sind der moderne Nachfolger. SQL ruft weiterhin nativen Code auf, die Integration erfolgt jedoch über Firebirds moderne Plugin- und Objekt-API. Datentypen, NULL-Behandlung, Metadaten, Zeichensätze und Lebenszyklus sind sauberer eingebunden. Für neue Erweiterungen unter Firebird 5 sollte eine UDR daher als natürlicher Ersatz für klassische UDFs betrachtet werden.
2. Alternative: Stored Functions in PSQL
Viele Algorithmen lassen sich vollständig als Firebird Stored Function in PSQL implementieren. Das vereinfacht die Verteilung erheblich: keine zusätzliche DLL, keine Linux-Shared-Library und keine plattformspezifische Binärdatei.
PSQL ist besonders interessant, wenn einfache Installation, Backup/Restore und Plattformunabhängigkeit wichtiger sind als maximale Rechenleistung. Entscheidend ist nicht, ob PSQL eine Aufgabe lösen kann, sondern ob seine Geschwindigkeit für das konkrete Aufrufvolumen ausreicht.
3. Warum phonetische Namenssuche?
Exakte Stringvergleiche sind bei Namen oft unzureichend. Klemt, Klemmt, Klempt und Klemp sind technisch vier unterschiedliche Zeichenketten, können aber bei einer Personensuche zusammengehören.
Phonetische Algorithmen bilden Namen auf Codes ab, die sich stärker an der Aussprache als an der exakten Schreibweise orientieren. Dadurch lassen sich Tippfehler, historische Schreibweisen und Varianten besser erkennen.
4. Soundex
Soundex erzeugt typischerweise einen kurzen Code aus einem Anfangsbuchstaben und Ziffern für ähnlich klingende Konsonantengruppen. Das Verfahren ist einfach und schnell, wurde jedoch primär für englische Namen entwickelt.
Im Projekt wurden deshalb SOUNDEX und SOUNDEX_DE umgesetzt. Die deutsche Variante normalisiert unter anderem Ä/AE, Ö/OE, Ü/UE, ß/SS sowie typische Buchstabenkombinationen.
5. Kölner Phonetik
Für deutsche Namen ist die Kölner Phonetik häufig geeigneter. Sie arbeitet mit kontextabhängigen Regeln und erzeugt eine Ziffernfolge variabler Länge.
Klemt → 4562, Klemmt → 4562, Klempt → 45612, Klemp → 4561. Klemt und Klemmt werden damit direkt phonetisch identisch; die anderen Varianten liegen nur geringfügig entfernt.
6. Distanz und Similarity
COLOGNE_DISTANCE berechnet zunächst für beide Namen die Kölner Phonetik und anschließend die Levenshtein-Distanz der Codes. 0 bedeutet identisch; 1 bedeutet eine notwendige Einfügung, Löschung oder Ersetzung.
PHONETIC_SIMILARITY übersetzt dies in einen Wert von 0 bis 100. In unserem Beispiel ergeben Klemt/Klemmt 100, Klemt/Klempt 80 und Klemt/Klemp 75.
7. Drei Implementierungen, gleiche Ergebnisse
Die fünf Funktionen SOUNDEX, SOUNDEX_DE, COLOGNE_PHONETIC, COLOGNE_DISTANCE und PHONETIC_SIMILARITY wurden als PSQL, als Lazarus/FPC-UDR und als Visual-C++-UDR umgesetzt.
Vor dem Performancevergleich wurden 10.000 Testdatensätze geprüft. In der finalen Version gab es bei allen fünf Funktionen 0 Abweichungen. Identische Checksums stellten zusätzlich sicher, dass alle Implementierungen dieselben Ergebnisse verarbeiteten.
8. PSQL versus native UDR
PSQL erwies sich bei den einfachen phonetischen Funktionen als überraschend brauchbar. Mit zunehmender Rechenarbeit wächst der Vorteil nativer UDRs deutlich, besonders bei Distanz- und Similarity-Berechnungen.
|
Funktion |
Native UDR (typisch) |
PSQL (typisch) |
Einordnung |
|
SOUNDEX |
~0,04 s |
~0,8 s |
Native deutlich schneller |
|
SOUNDEX_DE |
~0,05 s |
~0,9 s |
Native deutlich schneller |
|
COLOGNE_PHONETIC |
~0,04 s |
~1,6 s |
Native deutlich schneller |
|
COLOGNE_DISTANCE |
~0,06 s |
~4,5 s |
Native sehr deutlich schneller |
|
PHONETIC_SIMILARITY |
~0,06 s |
~6,5 s |
Native sehr deutlich schneller |
Die absoluten Zeiten stammen aus unterschiedlichen Benchmarkformen und sind deshalb keine reine Mikrobenchmark-Ratio. Die Aussage bleibt: PSQL ist funktional und bei einfachen Aufgaben durchaus schnell; native UDRs skalieren bei intensiver Berechnung erheblich besser.
9. Der erste C++-gegen-Pascal-Vergleich
Die erste FPC-Version verwendete UnicodeString, UnicodeUpperCase und allgemeine Stringoperationen. Die C++-Version arbeitete dagegen weitgehend direkt auf UTF-8-Bytes. Im ersten Test erschien C++ dadurch teilweise vier- bis fünfmal schneller.
Das war kein fairer reiner Compilervergleich: Die Implementierungen verrichteten intern unterschiedlich viel Arbeit.
10. Den Vergleich fair machen
Die FPC-Version wurde auf denselben Low-Level-Ansatz umgebaut: UTF-8 bleibt im Hot Path byteorientiert, deutsche Sonderzeichen werden über ihre UTF-8-Sequenzen normalisiert, ASCII-Großschreibung erfolgt direkt, temporäre Stringoperationen werden reduziert und Cologne/Levenshtein verwenden kompaktere Buffer.
Die SQL-Schnittstelle und die Ergebnisse blieben unverändert.
11. Optimierungseffekt in Free Pascal
|
Funktion |
FPC ursprünglich |
FPC Fast UTF-8 |
Beschleunigung |
|
SOUNDEX |
~136 ms |
~40 ms |
~3,4× |
|
SOUNDEX_DE |
~79 ms |
~47 ms |
~1,7× |
|
COLOGNE_PHONETIC |
~152 ms |
~43 ms |
~3,5× |
|
COLOGNE_DISTANCE |
~269 ms |
~62 ms |
~4,3× |
|
PHONETIC_SIMILARITY |
~271 ms |
~62 ms |
~4,4× |
Der größte Performancegewinn entstand also ohne Wechsel der Programmiersprache.
12. Optimiertes FPC versus Visual C++
|
Funktion |
Visual C++ 2022 |
Optimiertes FPC |
C++-Vorsprung ungefähr |
|
SOUNDEX |
~34 ms |
~40 ms |
~18 % |
|
SOUNDEX_DE |
~38 ms |
~47 ms |
~24 % |
|
COLOGNE_PHONETIC |
~38 ms |
~43 ms |
~13 % |
|
COLOGNE_DISTANCE |
~51 ms |
~62 ms |
~22 % |
|
PHONETIC_SIMILARITY |
~52 ms |
~62 ms |
~19 % |
Mit vergleichbarer Implementierung schrumpfte der Abstand von scheinbar Faktor vier oder fünf auf typischerweise etwa 10 bis 25 Prozent.
13. Warum Lazarus nur Firebird.pas benötigt
Die Object-Pascal-Anbindung an Firebird ist für den Entwickler kompakt. Firebird.pas bündelt die wesentlichen Interfaces und Typdeklarationen in einer Pascal-Unit. Dadurch bleibt ein kleines Lazarus-UDR-Projekt übersichtlich und für Delphi-/Lazarus-Entwickler vertraut.
14. Warum Visual Studio mehr Header benötigt
Die C++-UDR verwendet Firebirds C++-Hilfsinfrastruktur mit UdrCppEngine.h, Message.h, Interface.h, ibase.h und weiteren Include-Dateien sowie Preprocessor-Hilfen.
Das sind überwiegend Compile-Time-Abhängigkeiten. Die fertige DLL benötigt nicht einfach alle diese Header zur Laufzeit. Pascal bündelt viele Deklarationen in einer Unit; C++ verteilt die API stärker auf Header, Templates und Makros.
15. Windows und Linux
PSQL ist innerhalb der Datenbank plattformneutral. Native UDRs müssen für die Zielplattform gebaut werden: typischerweise DLL unter Windows und Shared Library unter Linux. Der SQL-Vertrag kann gleich bleiben, die Binärdatei muss jedoch zu Betriebssystem, Architektur und Firebird-Server passen.
16. Praktische Entscheidung
Für moderate Aufrufzahlen und maximale Einfachheit ist PSQL attraktiv. Für hohe Aufrufzahlen oder rechenintensive Algorithmen bietet eine native UDR deutliche Vorteile.
Wenn bereits Delphi-/Lazarus-/FPC-Know-how vorhanden ist, gibt es nach unseren Messungen keinen Grund, allein aus Performance-Angst auf C++ zu wechseln. C++ bleibt ebenso eine ausgezeichnete Wahl, wenn entsprechende Erfahrung und Build-Infrastruktur vorhanden sind.
17. Die wichtigste Erkenntnis
Ausgangspunkt war die Frage, wie klassische Firebird-UDF-Funktionalität unter Firebird 5 sinnvoll modernisiert werden kann. Daraus entstand ein Vergleich von UDR und PSQL und schließlich ein direkter Test von Free Pascal und Visual C++.
Die wichtigste Erkenntnis ist nicht eine einzelne Millisekundenzahl: Architektur, Algorithmus und Datenrepräsentation dominieren häufig die Wahl der Sprache. Unsere erste Pascal-Implementierung war korrekt, verwendete aber komfortable allgemeine Unicode-Abstraktionen. Die C++-Implementierung arbeitete näher an den tatsächlich benötigten Bytes und war zunächst dramatisch schneller. Nachdem dieselben Prinzipien auf Free Pascal übertragen wurden, verschwand der größte Teil des Unterschieds.
Für Entwickler, die seit vielen Jahren mit Delphi oder Free Pascal arbeiten, ist das bemerkenswert: Gut geschriebener Pascal-Code ist auch heute konkurrenzfähiger nativer Code. Visual C++ blieb in unserem Test etwas schneller, aber der verbleibende Abstand lag eher im Bereich von etwa 10 bis 25 Prozent als bei Faktor vier oder fünf.
Gleichzeitig hat Firebird PSQL positiv überrascht. Nicht jede Funktion rechtfertigt eine native Bibliothek. Einfache phonetische Funktionen können als Stored Function eine attraktive Kombination aus Performance, Wartbarkeit und problemloser Verteilung bieten. Native UDRs werden dort besonders interessant, wo hohe Aufrufzahlen und komplexere Berechnungen zusammenkommen.
Die praktische Schlussfolgerung lautet deshalb: Zuerst den richtigen Algorithmus und die richtige Datenrepräsentation wählen, dann die passende Deployment-Strategie entscheiden – und erst danach die Programmiersprache als Performancefaktor bewerten.
18. Demo-Projekte und Reproduzierbarkeit
Die vollständigen Quelltexte werden bewusst nicht im White Paper abgedruckt. So bleibt das Dokument auch für Entscheider und Anwender lesbar.
Demo-Projekte für Firebird PSQL, Lazarus/Free Pascal und Visual Studio/C++ können auf Anfrage bereitgestellt werden. Benchmarkwerte sind Momentaufnahmen: Hardware, Firebird-Version, Compileroptionen, Datenverteilung, Cache-Zustand und Serverlast beeinflussen absolute Zeiten. Reproduzierbare Testdaten, identische Ergebnisse und mehrere Messläufe sind deshalb wichtiger als eine einzelne Bestzeit.